/figures/ › 真图案例库
论文 Pipeline 真图案例库
真实论文原图 · 按构图类型分组 · 每类一张「怎么画」配方卡 · 图卡点开对照着画
这页与 /figures/ 的关系
/figures/ 里的「顶会 Pipeline 案例解剖」给出的是 简化重绘 的示意图,用于剖析构图、流向与配色。 这页是它的镜像,直接放上 论文中的原始真图,帮你看清:原作里到底画了多少细节、文字怎么放、配色到底用了什么。 两页对照读,效果最好。
每组左侧是「怎么画」配方卡,滚动右侧真图时常驻可见;图卡默认收起,点开标题即可对照着画,每组第一张已替你展开。
所有原图均来自 arXiv 公开 PDF,仅做画幅裁切与 PNG 重编码;版权归各论文。点击图片跳转 arXiv 详情页。
分组直达: A · 横向多阶段 B · 对比式 C · 双流对称 / 汇聚 D · 重参数 / 编解码 E · 工业 LLM 架构 F · 通用教程
A横向多阶段(线性流水线)
最常见的 pipeline 画法:左→右一条主轴,每段是显式步骤。适合训练阶段、数据加工、模型主链。
01InstructGPT(NeurIPS 2022)· 三步 RLHF三幕式▾
RLHF 训练流程图被引用最多的范本。每步是「数据 → 模型 → 产物」的小闭环,三步纵向对齐形成隐式时间轴。
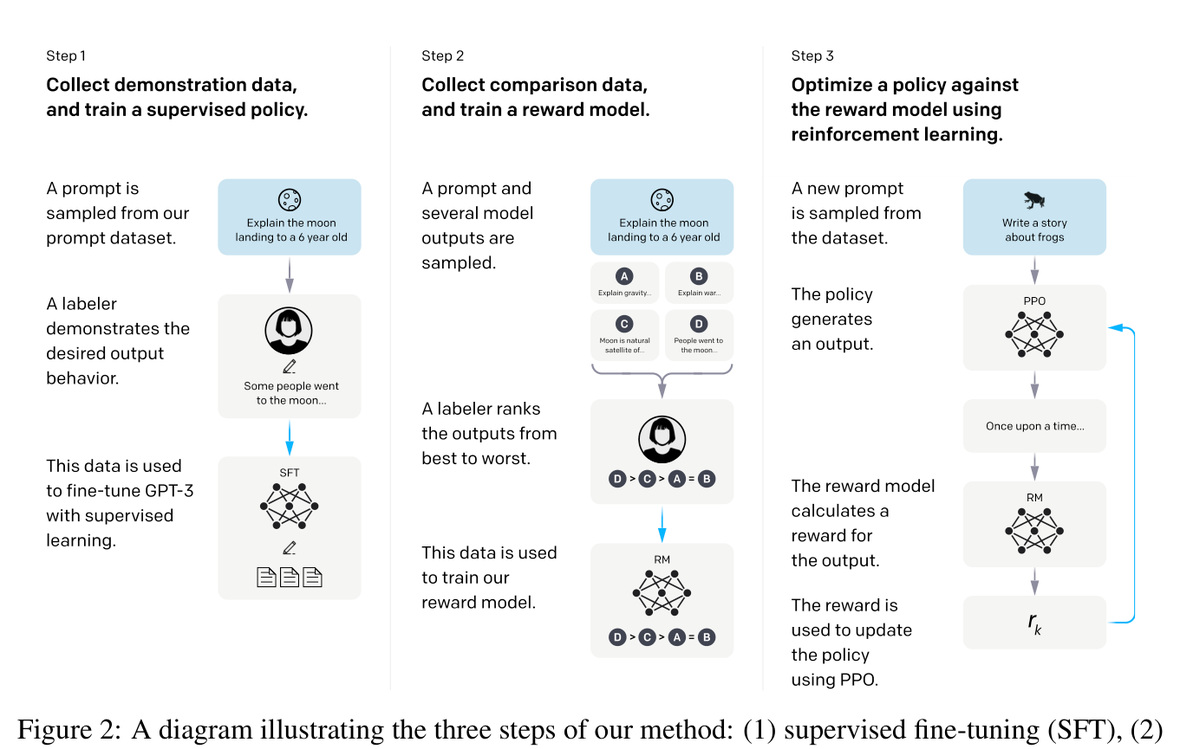
- 三步结构完全等宽对齐,标题统一用蓝色 step 标签,下方配一句动作描述,读者「读一行就能复述流程」。
- 同一套 icon(数据堆叠 / 小人 / 模型节点 / 排序序号)跨步复用,强化「同一条主线」。
- 第三步独有的回环箭头(PPO ↔ RM)打破横向单调,把「训练回路」和「数据流」在视觉上拆开。
02Whisper(OpenAI Tech Report 2022)· 多任务到序列到序列多段递进▾
整张图分上下两大舱:上半 = 模型架构,下半 = 多任务训练格式。舱之间用灰底块框住,避免与中间的 Transformer 流程混淆。
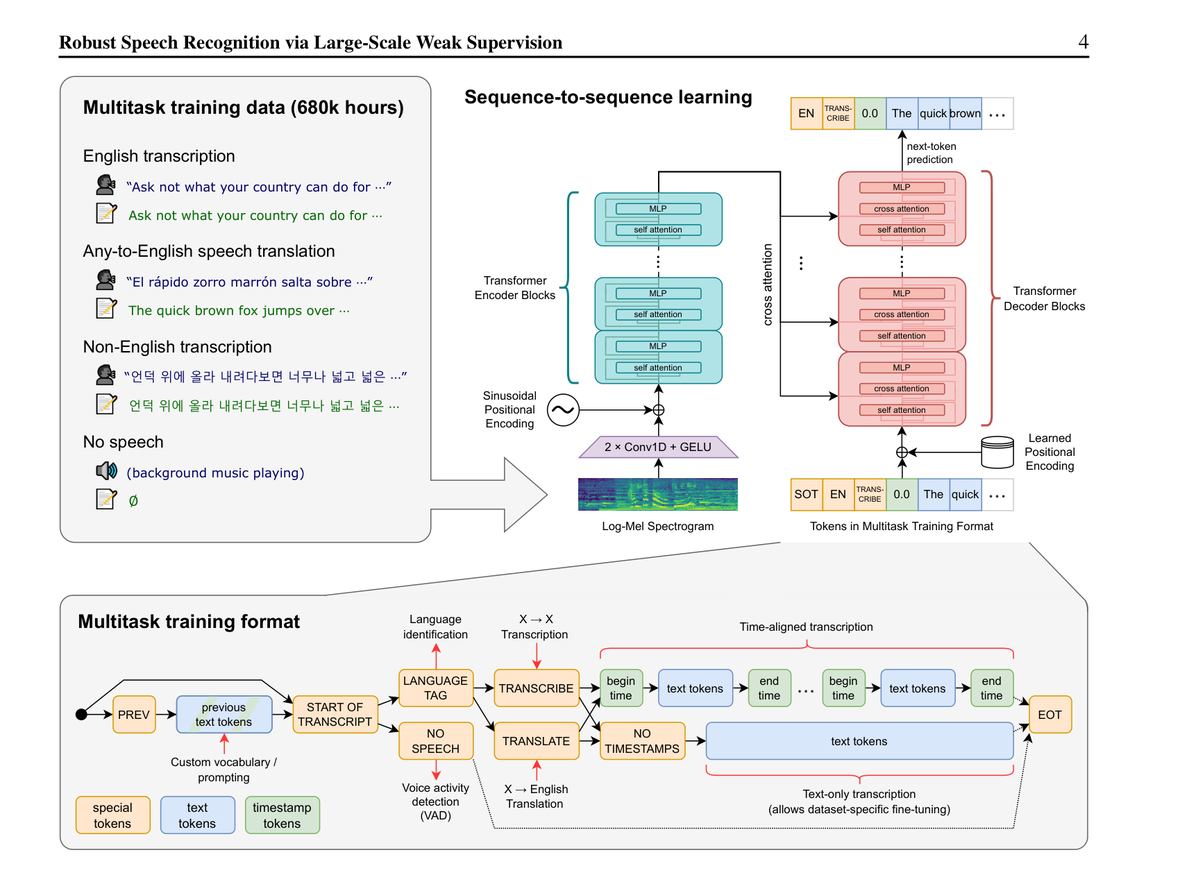
- 两块大舱用同一灰色边框,舱内各自再分小步骤,读者先看到「数据 / 模型」两件事,再去看舱内细节。
- 不同 token 类型用颜色块(special / text / timestamp),舱下的小图例就地解释,不强求翻正文。
- Encoder 与 Decoder 用同一蓝 / 红双色,跨模块守恒,视觉锚定「两边各司其职」。
03RAG(NeurIPS 2020)· 检索 + 生成端到端反传双模块端到端▾
左侧问题示例(蓝色块)→ 中间 retriever(绿底圆角框)→ 中间文档索引(紫色堆叠)→ 右侧 generator(蓝色圆角框)→ 右侧答案示例(紫色块)。
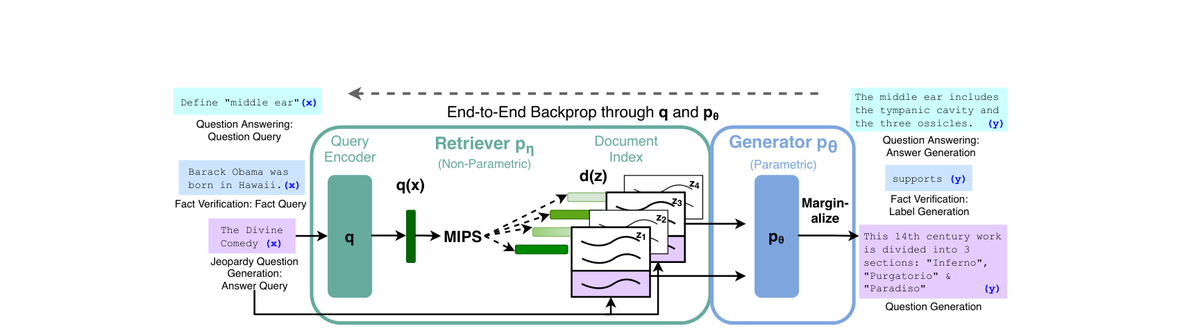
- 大标题「End-to-End Backprop through q and p_θ」横贯全图顶,把「端到端」这件事写在视觉中心,论文最重要的贡献被一句话点出。
- 两类问题(x / y)配色区分但位置对称,体现「输入不同 / 处理同一条管线」。
- 右上角的 d(z) 分布直方图把抽象「软检索」可视化为概率,避免读者把它误解为硬选择。
04FD-LLM(arXiv 2024)· 双路故障特征 + LLM工业时序 + LLM▾
典型的「领域知识 → 文本化 → LLM 推理」管线。上下两条平行子流(FFT processed data / Statistically processed data),最后汇入同一个 LoRA 微调后的 LLM。
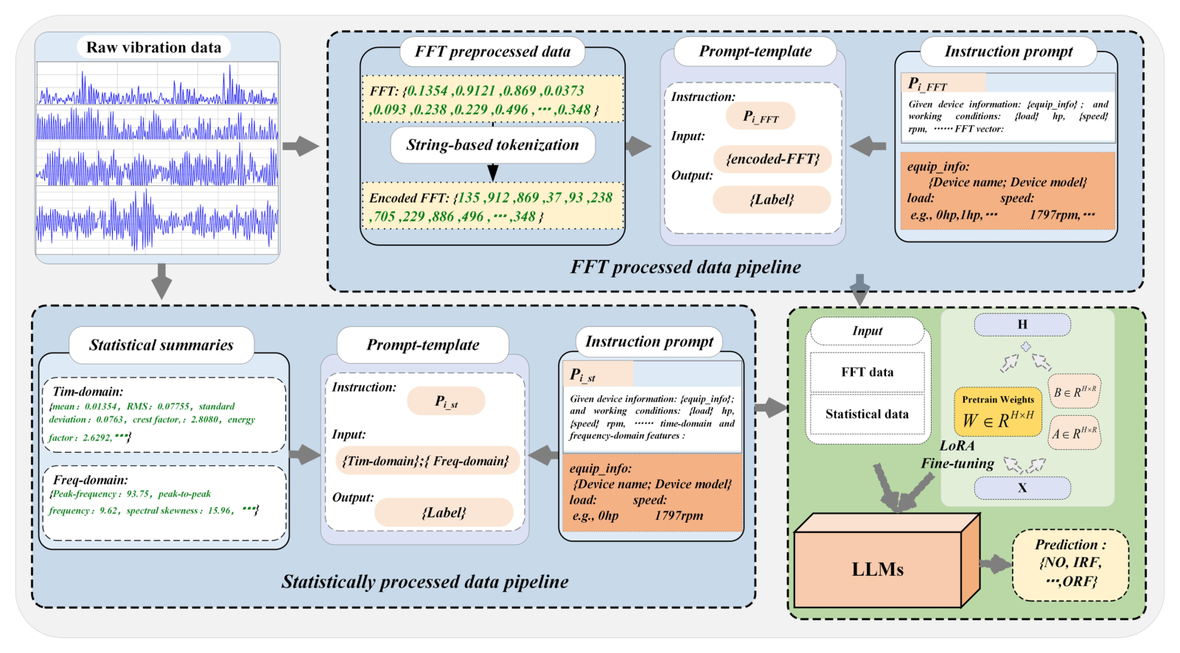
- 同色边框(蓝 / 绿)= 同类模块(数据加工 / 提示组装 / LLM),读者一眼看到「三大块」,不被十几个细节淹没。
- 两条平行子流而非合并表达式,这是论文的核心主张:「两种加工方式都能用」,没有「主次之分」。
- 把 LoRA 模块画得跟 W / A / B 等权重块并排,暗示「微调不重写大模型」,这是节省算力的关键卖点。
B对比式(左右并列新旧方法)
把「过去做法」放左边、「我们的做法」放右边,复用同一坐标系让读者一眼看到「我们少做了什么 / 多做了什么」。
05DPO(NeurIPS 2023)· RLHF vs Direct Preference Optimization方法对比▾
用同一个偏好数据作起点,左边走 RLHF(preference data → RM → 强化学习 → policy),右边走 DPO(preference data → 直接最大似然 → final LM)。
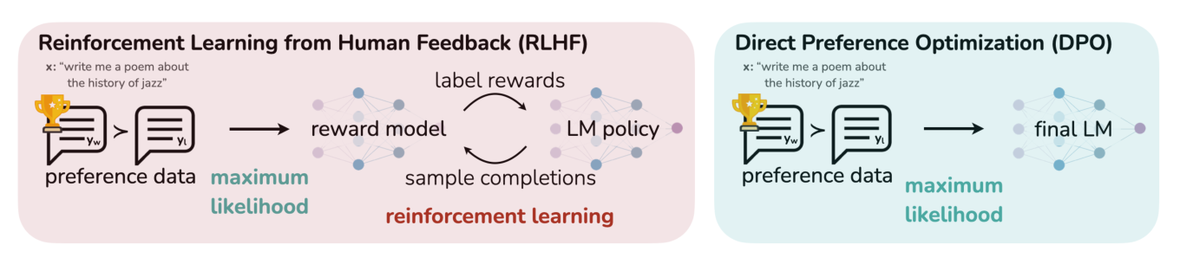
- 左右两舱同一红 / 绿主色块,红色 = 复杂度(RLHF 三件套),绿色 = 简化(DPO 单链)。颜色本身就是结论。
- 两边共用同一组小 icon(人 / 对话 / 模型节点),保留「输入相同」的视觉锚点。
- 不画任何坐标系或公式,只画结构差异,这是「对比式 pipeline」比曲线图更强的场景。
06Self-RAG(ICLR 2024)· RAG vs Self-RAG方法对比▾
左半画 vanilla RAG 的两步「检索 K 段 → prompt LLM 生成」,右半画 Self-RAG 的三步「按需检索 → 并行生成 → critique 选最优」。
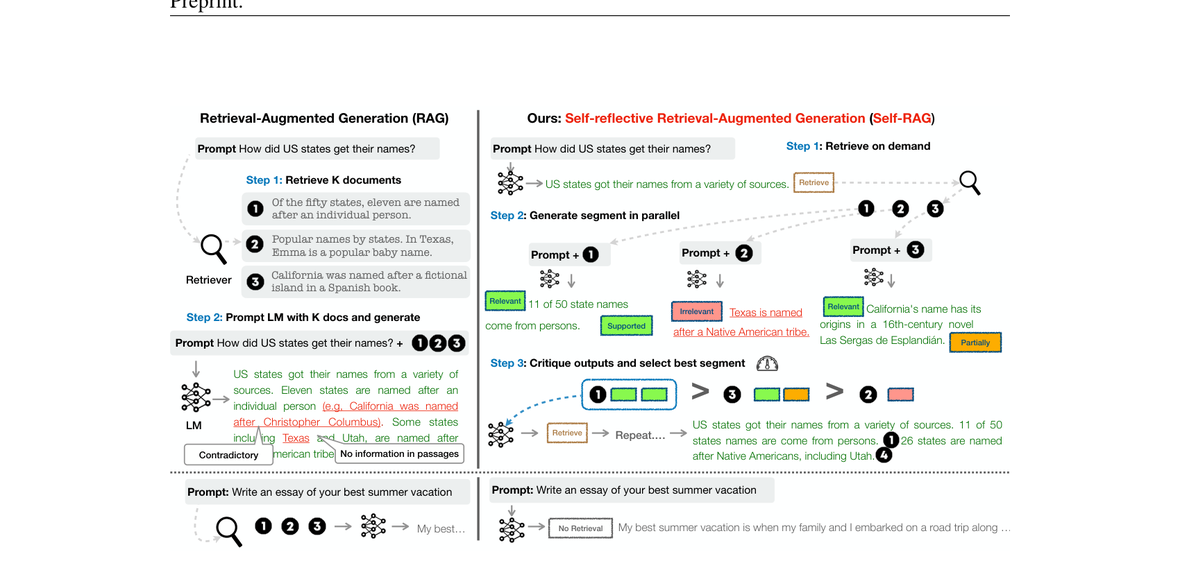
- 左半用一条主轴把 K 段堆叠并联,表达「一锅端」;右半用分支结构表达「并行抽样 + 评估筛选」,同一概念被画成两种典型形态。
- 「Relevant / Irrelevant / Supported」等小标签色块统一用橙 / 绿,左右两栏共用一套评价色,跨栏可比。
- 底部两个 prompt example 并排:一个「需要检索」,一个「不需要检索」,直接展示 Self-RAG 的「按需」特性。
07ReAct(ICLR 2023)· 四种 prompting 对比多路对比▾
横向四个 variant(Standard / CoT / Act-only / ReAct)跑同一个 HotpotQA 题,纵向两个任务(HotpotQA / AlfWorld)跑同一套方法,四块网格直接拼成 4×2 的事实证据。
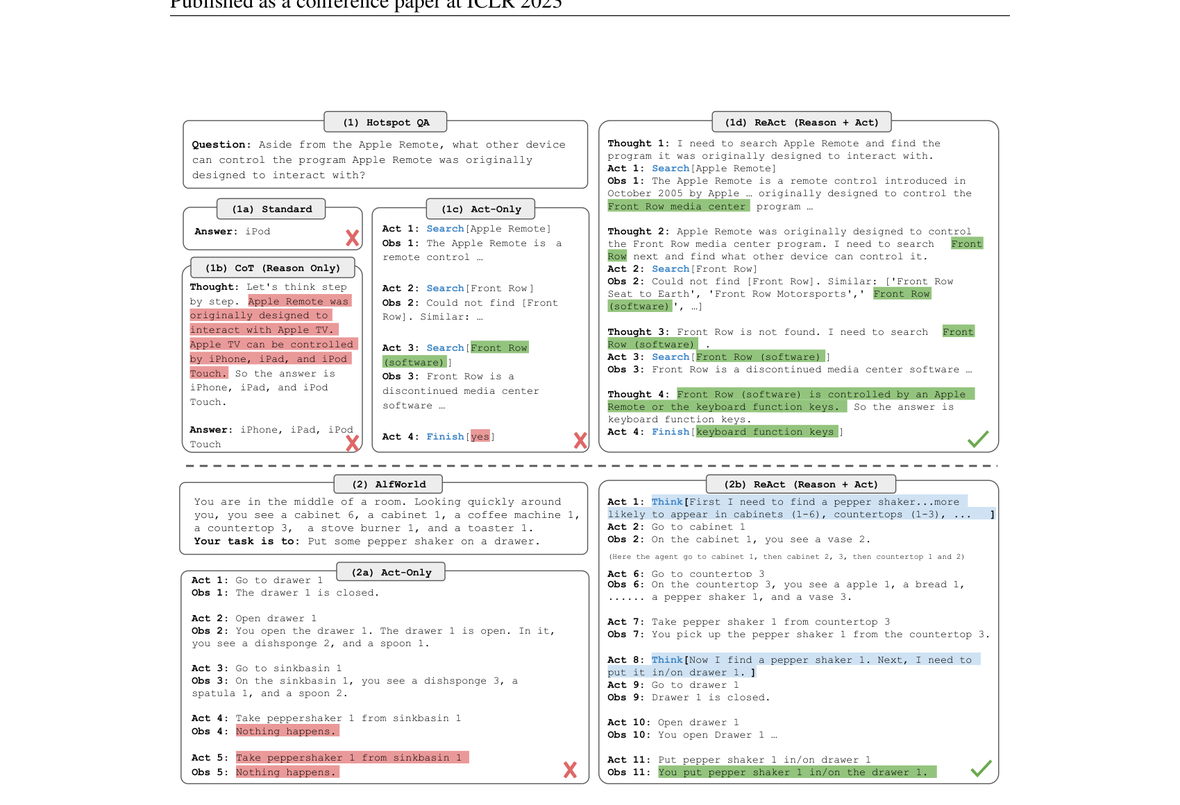
- 同一道题同一份答案结构被复用 4 次,读者不需要额外解释,差异自然显现:「同样的输入、不同的解题路径」。
- ✅ / ❌ 符号直接画在答案右侧,结论在图里、不在 caption 里,扫一眼就懂哪种方法对、哪种错。
- 绿色高亮(搜索词)和红色高亮(错误步骤)跨四格守恒,「动作」与「思维」两类操作各自有颜色身份。
08QLoRA(NeurIPS 2023)· Full / LoRA / QLoRA 三方对比三方对比▾
三个图元从同一「16-bit Transformer」基座出发,依次减少 optimizer state、冻结 base model、把 base model 量化到 4-bit,左→右就是论文贡献的累加。
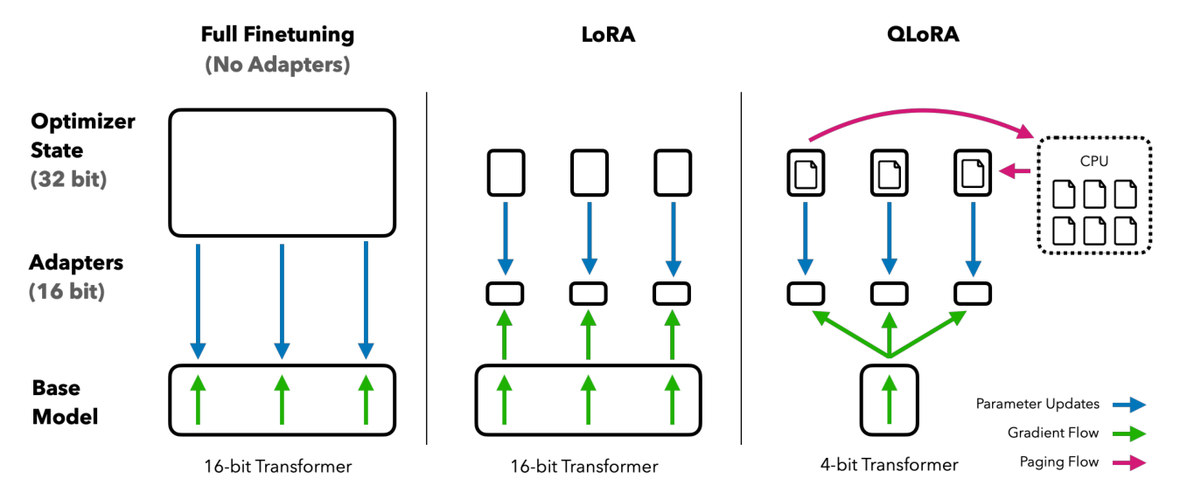
- 三栏对齐到同一基座框(Base Model 行),上面用空白 / 缩小 / 4-bit 灰度差异直接「画出内存节省」,比表格直观得多。
- 箭头图例(蓝 / 绿 / 紫 = 参数 / 梯度 / paging)就地嵌在右下角,不需要读者翻图例页。
- CPU paged-optimizer 块是全场唯一紫色,新引入的组件用新颜色,读者一眼知道「多出来的是什么」。
C双流对称 / 汇聚
两组处理流(视觉 vs 文本 / 源域 vs 目标域)从两端对称出发,最后汇聚到一个矩阵 / 一个共享空间。
09CLIP(ICML 2021)· 图文双塔 + N×N 矩阵双流汇聚▾
上:文本「Pepper the aussie pup」→ Text Encoder → 文本向量序列。下:图片堆栈 → Image Encoder → 图向量序列。中间 N×N 矩阵的对角线高亮 = 匹配对。
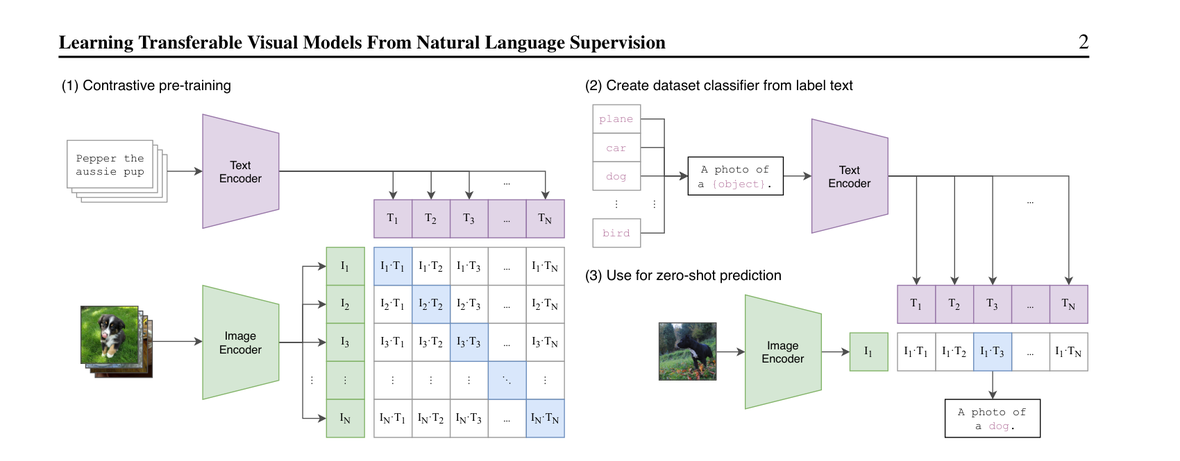
- 整张图把论文的「三件事」分成三个子图(contrastive pre-train / dataset classifier / zero-shot prediction),横向编号,等宽对齐,读者能复述出三个名词。
- 中间 N×N 矩阵对角线用浅蓝高亮,「匹配」这件事在视觉中心,不需要文字解释。
- 紫色 = text、绿色 = image,两种模态从头到尾两种颜色,连 N×N 矩阵里的色块都遵守同一规则。
10Time-LLM(ICLR 2024)· 时序重编程 LLM 三种范式三路汇聚▾
源模态 vs 目标模态两块同色框(浅灰),三种方法沿一条横轴并排:(a) task-specific 新建模型;(b) 模型微调;(c) 模型重编程,重编程那栏最复杂,所以占最大篇幅。
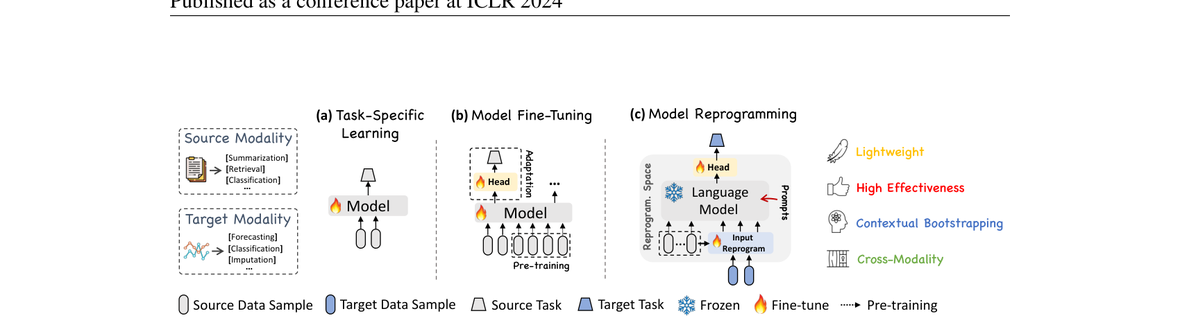
- 三栏用同一「源 → 目标」骨架,但栏内元素数量呈递增,视觉重量直接告诉读者「(c) 最复杂,也是本文工作」。
- 把「Reprogram. Space」和「Prompt + Reprogram.」单独画出来,是论文两个最关键的概念,图标和文字的耦合比纯文字描述快 5 倍。
- 右下角四件套图例(羽毛 / 点赞 / 灯泡 / 拼图)= 「Lightweight / High Effectiveness / Contextual Bootstrapping / Cross-Modality」,把论文四个卖点排成同一行,配合上方的复杂图做总结,读者滑到底不会错过。
D重参数 / 编解码(串行分解或对称)
表达「一个完整的算子被拆成两到三个简单子结构」。常用于参数高效微调、视觉预训练、自回归解码。
11LoRA(ICLR 2022)· 预训练权重 + BA 低秩分解重参数化▾
左侧大蓝块(frozen pretrained W ∈ ℝd×d),右侧两片橙色梯形(B = 0、A = 𝒩(0,σ²)),中间夹 rank r,三件套画完,全文就讲完了。
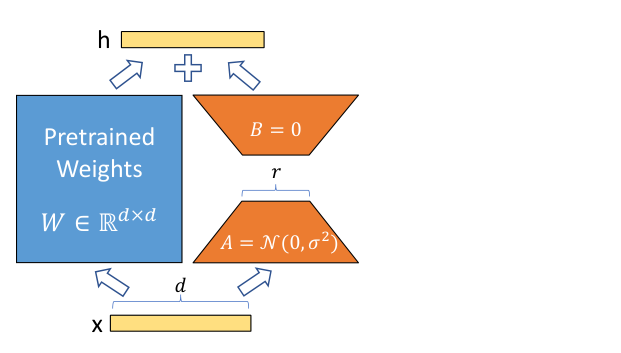
- 蓝色 = frozen,橙色 = trainable,颜色即参数状态,零文字成本解码「哪些参数会动」。
- 梯形几何形状本身就传达「rank r ≪ d」,维度差异不靠数字。
- 上下两条箭头(输入 / 输出)穿过 frozen W 和 BA 两条路,汇合后相加,「parallel additive」直接画进结构里,省掉文字解释。
12MAE(CVPR 2022)· 掩码自编码器流水线串行编解码▾
5 步串行:input(多数 patch 被灰块盖住)→ 可见 patch → encoder → latent tokens → decoder → target(原图)。中间两段用细窄「带状」画,形象表达「只过少量 token」。
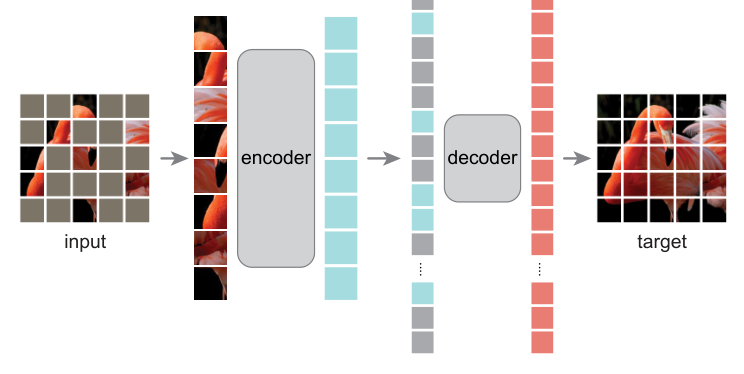
- encoder / decoder 用两块宽度完全不同的灰色圆角块,「encoder 大、decoder 小」这一非对称设计被画进几何里。
- 中间 token 序列用「带状小格」+「…省略号」画,读者一眼看出 token 序列在数据流里被压缩过。
- target 直接复用原图,「重建目标 = 原图」用同一张图来表达。
E工业 LLM 架构(故障检测 / 异常诊断)
把 LLM 当作诊断、解释、问答接口,嫁接到传统工业检测管线。多模块、多数据源、跨模态融合。
13AnomalyGPT(AAAI 2024)· 工业异常检测 + LLM工业 + LLM▾
三层叠合:上层 frozen image decoder(异常定位)、中层 frozen image encoder + prompt learner、下层 frozen LLM(人机问答)。底部 legend 把「frozen / trained / 矩阵乘 / cosine / element-wise」五种操作就地解释。
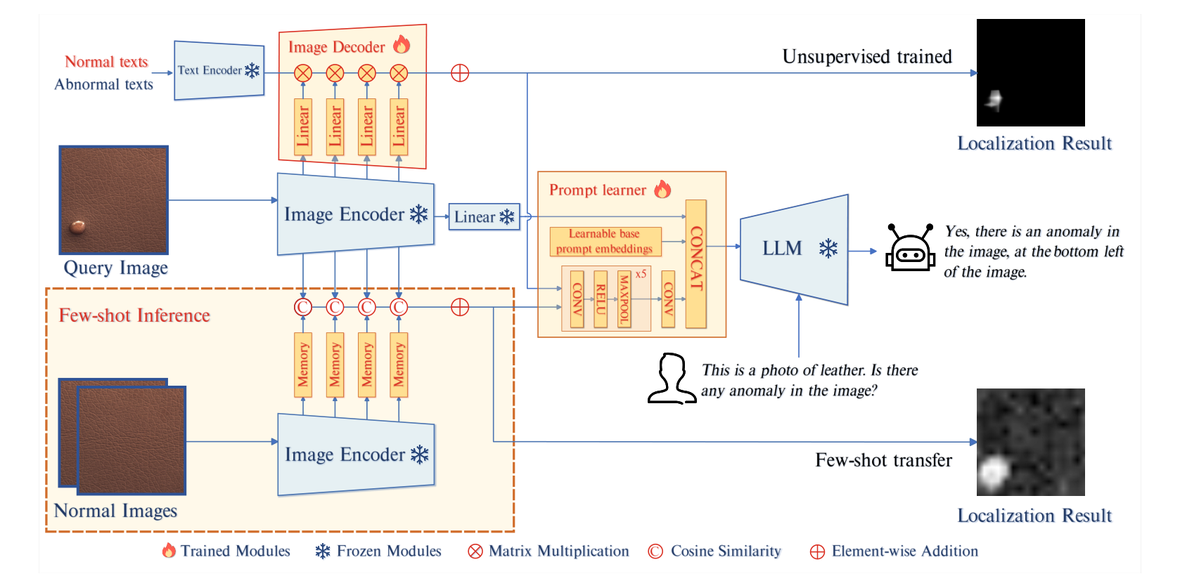
- 蓝色 = frozen(占画面 ~70%)、红色 = trained,颜色权重视觉化「参数冻结多、可训练少」这一部署要点。
- Few-shot Inference 块用橙色虚线框单独画,「这是另一种使用模式」,不与主流程混淆。
- 右上 / 右下两块 Localization Result(监督 / 无监督)输出端并排,同一模型两种用途被画进一张图里。
14LLM 轴承故障诊断(arXiv 2024)· 金字塔式框架LLM 故障诊断▾
金字塔顶层「LoRA / QLoRA 微调」,中层「三种加工路径(feature-based / data-based / embedding + patching)」,底座「原始振动信号」。三层之间用斜体灰色描述连系「数据从粗到细」。
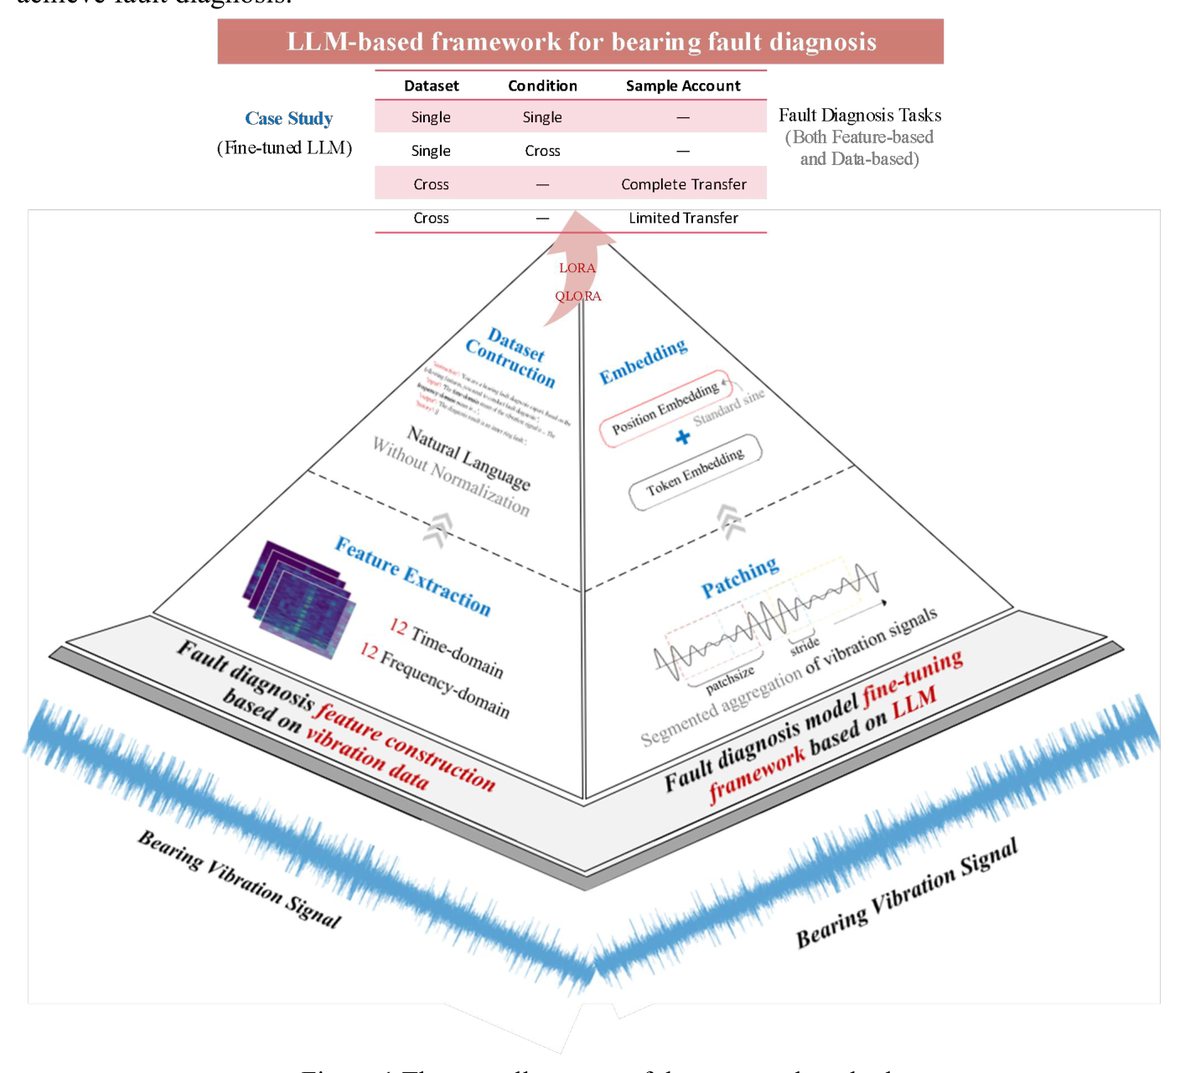
- 金字塔形状本身就是「抽象层级」的可视化,底层最具体的振动波形,到顶层最抽象的 LLM 微调,读者不需要图例就懂。
- 三种路径(feature / patching / case study)用同一蓝色斜体,跨路径守恒,强化「同一种 LLM 输入」。
- 顶部红色 LoRA / QLoRA 旗帜,一眼看到「这是基于 LLM 的工作」,图本身就把论文卖点写在顶角。
F怎么画出来这些图(30 分钟上手)
A–E 每组左侧已经放了该构型的「怎么画」配方卡;本区收通用内容:工具教程、绘图纪律与可查证出处。前面 14 张顶会图 90% 出自 draw.io / PowerPoint / matplotlib 三件套,工具不重要,叙事才重要。想看完整方法论、投稿自查清单与 10 张可复制 matplotlib 模板,去 /figures/#howto。
通用五步法
从叙事到导出,所有 pipeline / 架构图都跑得过下面这张表。
| 步骤 | 干什么 | 检验标准 |
|---|---|---|
| 1. 写主线 | 用一句话说清「X 用几步得到 Y」 | 同门 10 秒能复述出来 |
| 2. 列模块 | 拆成 3–6 个模块,标 frozen/trainable + 数字 | 每个模块在框里能一行装下 |
| 3. 套模板 | 从本页 A–E 选一个构图 | 一眼看不出「这是哪种模板」就对了 |
| 4. 上色 | 固定 3–4 色,每个颜色 = 一种角色 | 跨模块、跨子图颜色守恒 |
| 5. 导出 | 矢量 PDF/SVG,字号 7–9pt | 缩到 50% 仍能读 |
工具速查
| 场景 | 工具 | 上手 | 产出 |
|---|---|---|---|
| 想清楚结构 | 纸笔 / Excalidraw | 5 min | 草图 |
| 正式框图(顶会级) | draw.io | 30 min | SVG |
| 论文里直接拼素材 | PowerPoint | 30 min | PDF(矢量) |
| 代码化、批量、可复现 | matplotlib | 1 h | |
| LaTeX 原生、期刊要求 | TikZ | 2 h+ |
最小代码(matplotlib,13 行)
复制下面这段就能跑出上图。任何 pipeline 图都是这个骨架的扩展:改 box 数量 / 改文字 / 改颜色。
# 13 行画一张三框两箭头 pipeline(双栏宽 7.16 inch)
import matplotlib.pyplot as plt
from matplotlib.patches import FancyBboxPatch

fig, ax = plt.subplots(figsize=(7.16, 1.6))
ax.set_xlim(0, 10); ax.set_ylim(0, 3); ax.axis("off")

def box(x, text, fc="#e9f3fa", ec="#0072B2"):
    ax.add_patch(FancyBboxPatch((x, 1.1), 2.0, 0.9,
        boxstyle="round,pad=0.08", fc=fc, ec=ec, lw=1.4))
    ax.text(x + 1.0, 1.55, text, ha="center", va="center", fontsize=11)

def arrow(x0, x1):
    ax.annotate("", xy=(x1, 1.55), xytext=(x0, 1.55),
        arrowprops=dict(arrowstyle="->", color="#8b949e", lw=1.4))

for i, t in enumerate(["Raw Data", "Your Model", "Output"]):
    box(0.5 + i * 3.2, t)
    if i < 2: arrow(2.6 + i * 3.2, 3.6 + i * 3.2)

fig.savefig("pipeline.pdf", bbox_inches="tight")  # 矢量
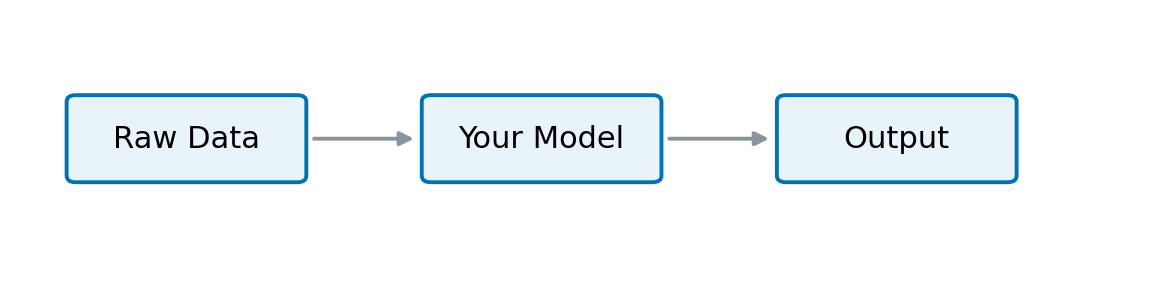
.py 文件就能跑出这张图。需要更多模块、改颜色、改大小?都是改 box() 调用行的事。完整可运行的 10 个模板(横向 pipeline、Transformer 堆叠、训练曲线、雷达图、热力图、箱线图、小倍数图、帕累托前沿等,每个模板都写了物理尺寸和导出设置): /figures/#fig-method
手把手 A · draw.io 画「三幕式」(15 min)
draw.io 是顶会作者最常推荐的工具,免费、矢量、所见即所得。本节用 InstructGPT 风格的「三幕」做演练。
- 新建图。打开
app.diagrams.net→ Device →Blank Diagram;左侧 Shapes 选 General → 拖入三个Rectangle。 - 改文字 + 圆角。双击矩形输入文字;右侧 Style 把
rounded设为1,fontSize设14。 - 统一尺寸 + 颜色。右侧 Style 设宽 200、高 80;填充
#e9f3fa浅蓝,描边#0072B2;选中按Ctrl+D复制两份。 - 等距对齐(关键一步)。Shift 多选三个框 → 顶部 Align →
Align Middle+Distribute Horizontally。 - 连接箭头。鼠标悬停矩形边缘出现方向箭头,拖到下一框即连接(带自动跟随)。选线 → Style 设 strokeColor
#8b949e。 - 语义分层。数据流用实线;参数更新(PPO ↔ RM、LoRA ↔ Backbone)选中线 → Style 设
dashPattern为8 4。 - 虚线分组框。拖一个大 Rectangle → 改填充
#f6f8fa、虚线dashPattern 8 4→ 右键Send to Back把矩形放最底层,作为「幕」背景。 - 导出矢量。
File → Export as → SVG,勾选Embed fonts和Include a copy of diagram。投稿时再导出 PDF 一份作为兜底。
手把手 B · PowerPoint 画法要点(20 min)
很多人论文里的「原图」其实是 PPT 拼出来的,尤其是融合多个 PDF 截图的图。下面是 PPT 画 pipeline 不会出错的几件事。
- 先把画布尺寸改对。Design → Slide Size → Custom(双栏图 7.16 in × 3.5 in;单栏 3.5 × 3.5 in)。先定尺寸再画,否则最后缩放比例全乱。
- Insert → Shapes → Rounded Rectangle。按住 Shift 等比缩放;Shift 多选所有框 → Format → Align →
Align Middle+Distribute Horizontally(等距神器)。 - 箭头用形状里的
Right Arrow。不要用带渐变 / 阴影的「SmartArt」,印刷不友好。同样的 Align 步骤对齐到中线。 - Ctrl+G 把同一组打成组。防止后面对齐时散架。需要复用样式就复制整个组,组内样式继承。
- 导出 PDF,不要截图。文件 → 另存为 → PDF(切勿 PNG 截图!)。PDF 才是矢量,期刊才会收。字号 7–9pt 与正文一致。
配色守恒 · 反例清单
下面这些坑一旦出现,几乎等同于「我看不懂你在画什么」。投稿前自查一遍。
| 常见反例 | 为什么坏 | 改正 |
|---|---|---|
| 彩虹色 / 高饱和渐变 | 读者无法把颜色和角色绑定 | 固定 3–4 色,每个颜色只代表一种角色 |
| 3D 效果 / 阴影 / 玻璃感 | 印刷不友好,IEEE/ACM 直接拒 | 全平面,纯色块 |
| 图标题写在图内 | 图标题是 caption 的事 | 图内只留图例、关键标签 |
| 字号 < 7 pt 或 > 12 pt | 缩到双栏宽度后不可读 / 喧宾夺主 | 图内字号 7–9 pt 与正文一致 |
| 箭头全用同一种 | 读者分不清数据流 / 参数更新 / 反馈环 | 实线 / 虚线 / 双向 = 不同语义 |
| 同一组用不同色 | 读者误以为左右两栏是不同模型 | 颜色守恒:角色 = 颜色 |
十条绘图纪律(带出处)
把上面 14 张图的套路沉淀成可对表的清单。每条都标了出处,方便投稿前自查时回到原始来源核对。
- 一图一主张。一张图只讲一件事;两张图讲一件事不如合并,一张图讲两件事必须拆。Rougier 2014 Rule 2
- 箭头是动词。实线 = 数据流,虚线 = 训练更新 / 反馈环,粗细 = 数据量级;全图共用一套语义,不要「什么箭头都在用」。Wong 2011「Arrows」
- 颜色守恒。一个角色 = 一个颜色,跨模块、跨子图、跨前后图全程沿用;彩色留给主角,配角一律灰阶。Wong 2010「Color coding」
- 色盲安全。北欧裔约 8% 男性有红绿色觉缺陷,三位男性审稿人至少一位色盲的概率约 22%;红绿同图必自查。Wong 2011「Color blindness」
- 彩虹色阶禁用。jet / rainbow 亮度不均匀,引入的视觉误差可超过数据总变差的 7%;梯度数据换感知均匀色阶(viridis / batlow / ColorBrewer 顺序色)。Crameri, Shephard & Heron 2020
- 重复即折叠。N× 角标、省略号、黑盒包装都是合法减法;折叠前先展开一例给读者校验。
- 留白是信息。非重点组件画黑盒;每轮迭代删一个元素,删掉后主张不受损就永久删,不承载信息的墨水都是成本。Tufte data-ink ratio;Wong「Negative space」
- 字号守底线。先定最终物理尺寸(图内 7–9pt 与 caption 一致),成稿后不再缩放;Rougier 2014 Rule 5「Do Not Trust the Defaults」
- 对齐成模数。间距、圆角、线宽取同一基数的倍数(4 / 8 / 16 px);对齐是免费的秩序感,错位是昂贵的混乱。
- 矢量优先。框图与曲线一律 PDF / SVG,位图只留给热力图与照片;matplotlib 记得
pdf.fonttype=42。
经验来源(全部可查证)
纪律要可信,得有出处。下面 4 份是顶会级、被引最广的可公开验证资料,付费墙后的「内训资料」永远不应该取代它们。
- Rougier, Droettboom & Bourne (2014) · Ten Simple Rules for Better Figures · PLOS Comput Biol 10(9): e1003833 · CC0 开放,可自由转载。十条规则的原始出处。
- Wong B. et al. (2010–2015) · Points of View 专栏 · Nature Methods · 共 38 篇。本节引用了 Color coding (2010)、Arrows (2011)、Color blindness (2011)、Negative space (2011)、Pencil and paper (2012) 等篇目;专栏汇总页含全部 38 篇的链接。
- Crameri F., Shephard G.E. & Heron P.J. (2020) · The misuse of colour in science communication · Nature Communications 11: 5444 · CC BY 4.0。彩虹色阶的量化危害与免费科学色阶库(batlow 系列)。
- Tufte E.R. (1983) · The Visual Display of Quantitative Information · Graphics Press · 经典教科书。data-ink ratio、chartjunk 等概念从此处起源,Wong / Rougier 都直接引用过。
经验方法都是公开的、可追溯的;缺一不可复制,缺三不可信任。